Platform Cityはエージェント前提のPlatform Engineeringを検証する
Platform City チームの川村です。
前回は当日の体験を追いました。今回はその裏側の考え方、AI で Platform Engineering をやるとはどういうことなのか を書きます。
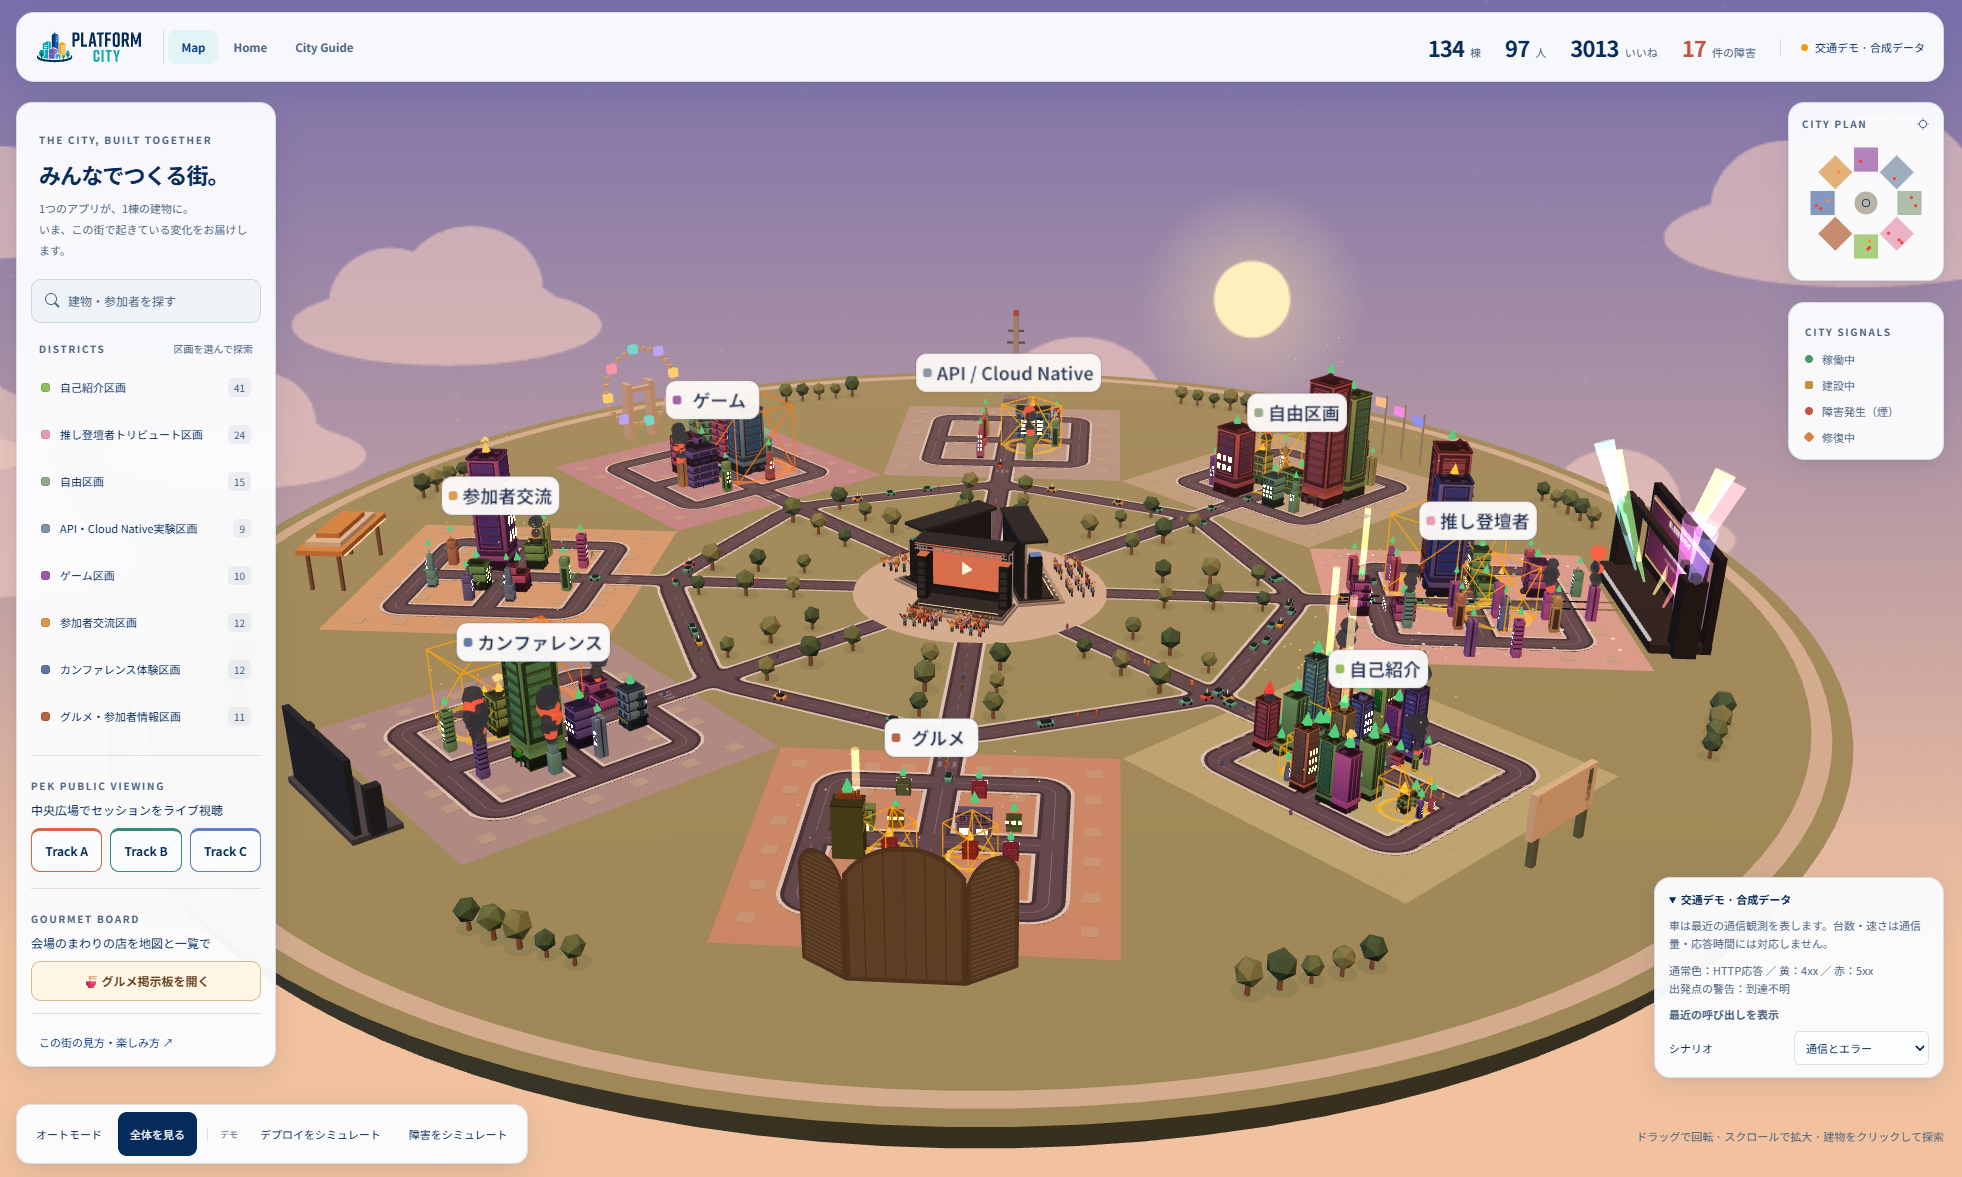
(本日の Platform City。街に車が走り出し、一気に活気がUP!!)
Platform City は100人以上が一斉にコーディングエージェントでデプロイするという極端な条件なので、普通の社内プラットフォームでは先送りにできる問いが、設計段階で全部表に出てきました。そこで何を考えて、何をどう作ったかの話です。
ポイントごとに、従来はこうだった → エージェント前提だとこう変わる → Platform City ではこうしたの順でご紹介します。
1. 顧客が人間からエージェントに変わる
従来: IDP(Internal Developer Platform)を作ると言えば、まずポータルでした。開発者の認知負荷を下げるために UI を磨く、という方向です。
変わること: 利用者がエージェントになると、磨くべき対象が UI ではなくなります。エージェントはボタンを押しませんし、ダッシュボードを眺めて察してもくれません。代わりに、ツールの入出力を読みます。
Platform City: 概要ページの記載と異なり、Backstage は結局入れませんでした。1日のイベントに対して構築・運用コストが重いうえ、エージェントはポータルを見ないからです。参加者の一級の入口は MCP サーバーで、操作の窓口はそこに一本化しています。
ただし人間向けの面を一切持たないわけではありません。そこは意識的に切り分けていて、人間向けには街、自分のアプリの状況を見る Home、思想と割り切りを書いた City Guide の3面を用意しています。人間には何が起きているかを見せ、エージェントには次に何をすべきかを返す。 同じ情報を同じ形で出そうとしないのがポイントだと思っています。
一方で、カタログ機能そのものは削りませんでした。register_api で自分の API を街のカタログに登録し、discover_apis で他の参加者の API を探せます。参加者Aのエージェントが参加者Bの API を見つけて自分のアプリに組み込んだ瞬間、プラットフォームが組織的理解を仲介することが会場で実演されたことになるので、ここは演出としても仕込んでいます。
2. golden path は agentic path になる
従来: golden path を支える中心的な部品のひとつは、テンプレートでした。推奨構成の雛形を用意して、そこから始めれば大きく外さない、という作りです。
変わること: 雛形程度なら、エージェントが数秒で書きます。scaffold コードそれ自体の価値は低下しました。ではテンプレートに何が残るのか。
Platform City: 残るのは配線済みの検証ループではないかと仮説を置きました。テンプレートが出荷しているのは、コードではなく最初から通る CIです。lint → test → build → イメージ push → デプロイが通った状態で払い出されるので、エージェントは1行も書かずに自分の変更が検証される環境を手に入れます。
また、検証可能性の規約を全テンプレートで統一しました。
- ヘルスチェックは
/healthzに固定(テンプレートのコードに同梱) - リッスンポートは 8080
- リソースは requests = limits
- CI の段階名も統一
地味ですが、これが揃っているから status が全アプリに対して一様に動きます。規約がバラバラだと、アプリごとに「このアプリのヘルスチェックはどこ?」を解決する処理が必要になり、観測シグナルの設計が崩れます。
あわせて、テンプレートには AGENTS.md を同梱しています。このテンプレートの制約、検証の方法、CI の各段階が何を検査するか、失敗したらどこを見るかは、この AGENTS.md と、後述するツールの description に集約されています。
3. エージェントの自律性を決めるのは、モデルではなくフィードバックの質
ここが本記事で一番ポイントになる部分だと思っています。
従来: デプロイを受け付ける API があれば、プラットフォームの仕事は一段落でした。失敗したら人間がログを見ればいい、という前提があるからです。
変わること: 前提が崩れます。エージェントがどこまで自律的に進めるかは、モデルのパラメータ数ではなく、プラットフォームが返す情報の質と粒度で決まります。
Platform City: 後述のnext_stepsや階層化されたシグナルなど、エージェントが自律的に動くためのフィードバックを充実させました。
ツールが「失敗しました(Internal Server Error)」とだけ返せば、どんなフロンティアモデルでも当てずっぽうを繰り返すしかありません。逆にどの段階で、何が、期待値に対して実際どうだったかが伝われば、一発で根本原因に向かえます。
そしてこれは同時に、イベント運営のリスクの問題でもあります。シグナルが貧しいと、参加者は動かない理由が分からないまま詰みます。100人分の詰みを当日の運営で捌くのは不可能です。逆にシグナルが豊かなら、エージェントが自分で直して、その様子自体が見せ場になります。つまり運営コストと見せ場が同じ設計判断を元にしています。
成功でも失敗でも next_steps を返す
全ツールのレスポンスに次にやるべきことを入れています。エラーも自由文にせず、機械可読な構造にしています。
たとえばアプリ数の上限に達したときは、上限に達した事実・許容されている最大数・枠を空ける方法がセットで返ります。リソース上限を超えたときは、こんな形です。
requests.cpu が上限を超えます(既存 750m + 追加分 500m = 1250m > 上限 2000m)Kubernetes の ResourceQuota 違反エラーに丸投げしない、というのを明示的なルールにしました。生の quota エラーは人間でも読みづらいので、control-plane 側で事前に計算して、式ごと返します。
さらに、control-plane 自体に繋がらなかったときも、MCP サーバー側で同じ形のレスポンスを合成します。「しばらく待ってから再試行してください」まで含めて、どんな失敗でも next_steps のある形を崩さないのが狙いです。このとき上流のレスポンス本文や例外の文字列は混ぜません。レート制限に当たったときも「あと何秒待てばいいか」を返すので、429 すらエージェントの待機ループに組み込まれます。
シグナルには階層がある
どこまでをプラットフォームが供給するのかを、最初に決めて書き出しました。
| 段階 | 何を検証するか | 誰が返すか |
|---|---|---|
| CI | lint / test | GitLab CI |
| デプロイ受理 | 宣言が妥当か、枠があるか | control-plane |
| ロールアウト | 対象イメージで Pod が揃ったか | control-plane |
| ヘルスチェック | /healthz が応答するか | プラットフォームの観測 |
| 公開 URL | 街の外から GET / が応答するか | 街の側の外形監視(BFF) |
| ランタイム | 起動失敗・イメージ取得失敗の理由 | control-plane の診断 |
公開 URL の層は後から足しました。/healthz は 200 なのに GET / が 500、というアプリを健康な建物として立たせないためです。
status は deploy のおまけではなく、同格の主要製品として設計すると決めました。デプロイが通った瞬間より、失敗したときに中で何が起きていたかを正確に知れることのほうが、トラブルシュートには効きます。
診断は固定ルールで書く。LLM は使わない
ランタイムの失敗理由を返す logs ツールは、一段踏み込んで設計しました。現在のログと再起動前のログに加えて、起動診断を返します。
- 段階(イメージ取得 / スケジューリング / 起動 / readiness / liveness など)、理由、期待値、実際値、
next_stepsを構造化して返す - 観測できなかった期待値は null にする。ログ本文から推測しない
- Pod のログだけでは足りないず、イメージ取得の失敗やスケジューリング失敗ではログが1行も生まれないので、関連する Events も一緒に返す
- ログ本文は「アプリ由来のデータ」として扱う。プロンプトインジェクションが入っている前提で扱う
そして、この診断に LLM は使いません。 例外は Home に出す障害ヒントで、HolmesGPT が原因の候補と確認手順を生成します。ただし読み取り専用の補助で、health や deploy の判定は一切変えませんし、生ログも渡しません。ツールの経路(status / logs)は固定ルールのままです。ここは次の論点に繋がります。
4. ツールは増やすほど悪くなる
従来: 従来、使われない API のコストを払うのは構築する提供側でした。利用者は呼ばなければ済みました。
変わること: MCP では違います。エージェントはツールリスト全体を LLM のコンテキストに載せます。 ツールを増やすと、不要な定義でトークンを食い、モデルが選択を誤ります。数が多すぎると、プラットフォームが親切になるどころか精度が落ちます。
Platform City: ツール数の上限を 10個と決めて、ADR に書いて固定しました。いま参加者に出しているのは7つです。
| ツール | 役割 |
|---|---|
onboard | テナントを作る(初回だけ) |
create_app | アプリを追加する |
deploy | 新しいイメージを配る |
status | 直近のデプロイの状況を見る |
logs | ログと起動診断を取る |
register_api | 自分の API をカタログに登録する |
discover_apis | 他の人の API を探す |
また、ツールの description がプロンプトとして有効に機能しました。たとえば推しの登壇者を宣言するパラメータには、こういう指示を埋めてあります。
推しアプリなら呼び出す前に誰を応援するか尋ねる(指定済みなら再質問しない)。登壇者データから ID を特定して保存する。箱推しは省略、未回答や曖昧な名前は確認し ID を推測しない。
discover_apis も、0件なら「まだ登録されている API はありません」、ヒットしたら各件に「利用する場合は deploy 時に consumes を指定してください」を必ず添えます。
ツール定義はスキーマではなく、エージェントへの指示書として書いています。
5. インターフェースは薄く保つ
Platform City の MCP サーバーは、意図的に驚くほど薄くしています。
- Kubernetes も Crossplane も GitLab も一切直接触りません。control-plane の API を1回呼ぶだけです
- control-plane が返した
next_stepsを書き換えずに透過します - バリデーションルールを足したくなったら、それは control-plane 側の変更であって、MCP サーバーでは直しません
こう決めておくと、「どこに何を書くか」で迷う時間がなくなります。MCP サーバーはプロトコルの変換層であって、ビジネスロジックの置き場ではない、という線を引いただけです。
transport は Streamable HTTP のステートレスにしました。ステートレスにできたのは、ツール呼び出しがどれも control-plane への HTTP リクエスト1回のみとなるため、リクエストをまたいで保持すべき状態が存在しないからです。セッションを持たないと決められたので、そのぶん作らなくていいものが増えました。
認証も同じ方針です。参加者には onboard 時にテナント固有のトークンを渡しますが、これは共有シークレットから HMAC で導出したもので、トークンの DB を持ちません。検証は control-plane 側だけで行い、MCP サーバーはヘッダーを透過するだけです。
6. gates から guardrails へ
従来: 統制は承認ゲートでした。本番リリースの承認、インフラ変更のレビューなど、人間が見て止める仕組みです。
変わること: 100人 × エージェントの物量に、人間の承認は追いつきません。そして追いつかないゲートは回避されます。統制を人間の注意力に置いておけなくなり、構造に埋め込むしかなくなります。
Platform City: 最初から承認ゲートなしで設計した代わりに、構造側を固めています。
- リソース上限: テナント単位の quota。超えるなら受理前に式つきで拒否
- レート制限: デプロイはテナントあたり60秒で10回まで。超えたら待つべき秒数を返す
- 同時実行数: クラスタ全体で同時にロールアウトするデプロイ数に上限を置く。同じアプリへの連続デプロイは1件ずつ直列にする
- 自由度の段階化: テーマごとに「Trust Tier」を割り当て、CI を触れる範囲と Kubernetes マニフェストを書ける範囲を段階的に変える。チュートリアル用の自己紹介アプリは完全固定、ゲームはビルド処理だけ自由、という設計です(現時点で GitLab 側のポリシーで強制しているのは自己紹介の Tier A だけで、B/C の強制はこれから)
ガードレールに当たったときのエラーは、検証シグナルとして設計しています。前述の通り、フィードバックを充実させることで、エージェントがその中で迷わず動けるようにするためのものです。
また、ガードレールは利用者が書き換えられない場所に置くと決めて進めました。CI の固定は GitLab のポリシーがプロジェクトの外側から上書きする形にしています。
7. プラットフォーム側は決定論的に保つ
ここまでの設計を貫いている原則があります。
LLM をプラットフォームの判定経路に持たないことです。 非決定性は参加者のエージェント側に置いて、プラットフォームは検証シグナルとガードレールを供給する側に徹するという立場です。テナントの払い出しも、デプロイの受付も、街の区画割り当ても、すべて同じ入力なら同じ結果を返す普通のソフトウェアとして書いてあります。
これは、非決定的な生成を、決定論的な検証の檻で包むという考え方をもとに設計したものです。エージェントのコード生成がどれだけ確率的でも、通過条件(lint が通る、テストが通る、ヘルスチェックが応答する)が完全に決定論的であれば、システムとしては成立します。
これを選んだメリットは3つあります。
- 障害調査が従来のデバッグ手法で完結する
- 負荷テストが再現できる
- 当日の挙動を運営が予測できる
今回のPlatform Cityでは、3つ目が特に重いです。100人が同時に使う一発勝負のイベントで、プラットフォーム側の挙動が確率的だったら、運営が持ちません。
「AI によって、これまでより良い開発者体験が作れる」ということを実現するにあたり、決定論的であることはその土台となっています。
終わりに
Platform City は、100人以上が同時にエージェントで開発・デプロイするという、この設計をそのまま試す場です。ここに書いたのは現時点での設計であって、証明された結論ではありません。本当に正しいかどうかは、当日に分かります。 実際に街を見て、答え合わせをしていただければと思います。
次回は、その検証シグナルが目に見える形になったもの、街の話を書きます。なぜ街にしたのか、そして参加者はどんな区画に何を建てられるのかをご紹介します。
また、Platform City の続報や当日の様子は、公式 X でも発信していきます。ぜひフォローして最新情報をチェックしてください! https://x.com/cnia_pfem(ハッシュタグ: #PEK2026)
Platform Engineering Kaigi 2026
- 開催日:2026年9月26日(土)
- 場所:中野セントラルパークカンファレンス
- 申し込み:FindyConference (一般申し込み、オンラインともにリンク先からの申し込みが必要となります)
- 問い合わせ:問い合わせフォーム